Что такое crawling в SEO?
Прежде чем поисковая система сможет понять веб-страницу или ранжировать её, ей обычно нужно сначала найти и получить её содержимое. Этот процесс называется crawling.
Поисковые системы используют автоматизированные программы — краулеры, боты или пауки — чтобы находить URL и запрашивать их содержимое. Основной поисковый краулер Google называется Googlebot. Он может обнаруживать страницы через ссылки, sitemap-файлы, ранее известные URL и другие сигналы, а затем загружать эти URL для дальнейшей обработки поисковыми системами. (developers.google.com)
На первый взгляд crawling кажется простым процессом, но проблемы со ссылками, robots.txt, сервером, редиректами, JavaScript или структурой URL могут помешать эффективному обнаружению важных страниц.
Краткий ответ
Crawling в SEO — это процесс, при котором поисковые боты обнаруживают и получают URL из интернета.
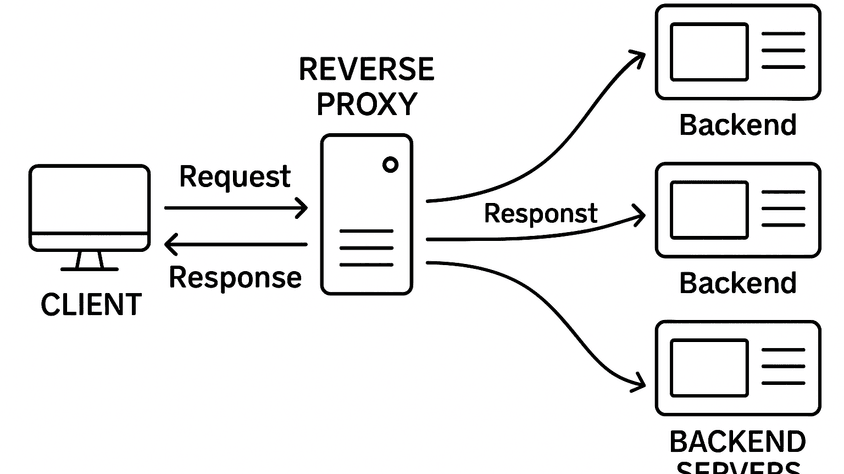
Краулер находит URL, проверяет, разрешён ли ему доступ, отправляет запрос серверу, получает ответ и может извлечь со страницы дополнительные URL.
Crawling не означает, что страница будет проиндексирована или начнёт ранжироваться. Он лишь делает страницу доступной для дальнейшей обработки. Google прямо указывает, что не каждая просканированная страница в итоге попадает в индекс. (developers.google.com)
Crawling и indexing
Эти процессы тесно связаны, но это не одно и то же.
| Этап | Что происходит |
|---|---|
| Discovery | Поисковая система узнаёт о существовании URL. |
| Crawling | Краулер запрашивает и получает URL. |
| Rendering | При необходимости краулер обрабатывает страницу и контент, созданный JavaScript. |
| Indexing | Поисковые системы анализируют контент и решают, должен ли он попасть в поисковый индекс и каким образом. |
| Serving | Проиндексированная информация может быть выбрана для показа в релевантных результатах поиска. |
Таким образом, страница может быть обнаружена, но не просканирована; просканирована, но не проиндексирована; или проиндексирована, но не занимать заметных позиций по конкретному запросу.
INTERNAL LINK: Что такое indexing в SEO?
Как работает crawling
В упрощённом виде процесс crawling выглядит так:
URL обнаружен → проверка разрешений на crawling → HTTP-запрос → ответ сервера → обработка контента → обнаружение ссылок → системы indexing
Предположим, Googlebot уже знает эту страницу:
https://example.com/blog/
На странице есть стандартная HTML-ссылка:
<a href="/blog/technical-seo/">Technical SEO</a>
Google может извлечь этот URL и добавить его в список адресов, которые могут быть просканированы. Google отдельно рекомендует использовать доступные для crawling элементы <a> с атрибутом href для ссылок, по которым его краулеры должны надёжно переходить. (developers.google.com)
После этого краулер может запросить:
https://example.com/blog/technical-seo/
Сервер может ответить статусом 200 OK, редиректом вроде 301, ошибкой 404 или серверной ошибкой, например 503.
Успешный ответ 2xx позволяет Google передать полученный контент на дальнейшую обработку, но даже успешный ответ не гарантирует indexing. Постоянные ошибки 5xx и ответы 429 Too Many Requests могут привести к тому, что Google снизит частоту crawling. (developers.google.com)
Как краулеры находят URL
Поисковым системам не требуется, чтобы вы вручную отправляли каждую страницу.
Внутренние и внешние ссылки
Ссылки — один из основных механизмов обнаружения страниц. Google указывает, что Googlebot в основном находит новые URL через ссылки на уже известных ему страницах. (developers.google.com)
Поэтому внутренняя перелинковка относится к техническому SEO, а не только к навигации.
Важную страницу, на которую не ведут доступные для crawling ссылки, краулерам может быть сложнее обнаружить. Такие страницы обычно называют orphan pages.
INTERNAL LINK: Внутренняя перелинковка для SEO
XML Sitemaps
XML sitemap предоставляет поисковым системам структурированный список URL, которые вы считаете важными.
Например:
<url>
  <loc>https://example.com/blog/technical-seo/</loc>
</url>
Google называет отправку sitemap подсказкой, а не командой или гарантией того, что каждый указанный URL будет просканирован или проиндексирован. Один sitemap ограничен 50 000 URL или 50 МБ без сжатия; более крупные сайты могут использовать несколько sitemap-файлов и sitemap index. (developers.google.com)
INTERNAL LINK: XML Sitemaps Explained
robots.txt и crawling
Файл robots.txt может сообщать совместимым краулерам, какие URL-пути им разрешено или запрещено запрашивать.
Например:
User-agent: *
Disallow: /admin/
Robots Exclusion Protocol был стандартизирован как RFC 9309 в сентябре 2022 года. Спецификация описывает краулеры как автоматизированные клиенты и подчёркивает, что правила robots.txt не являются системой контроля доступа или авторизации. (rfc-editor.org)
Это важное различие.
Если конфиденциальная информация должна оставаться закрытой, используйте аутентификацию или другой настоящий механизм контроля доступа. Не полагайтесь на robots.txt.
robots.txt — это не noindex
Одна из распространённых SEO-ошибок — считать:
«Если я заблокирую URL в robots.txt, Google не сможет его проиндексировать».
Это не всегда так.
Google может обнаружить заблокированный URL через ссылки и потенциально показать его в результатах поиска, не сканируя содержимое страницы. Поэтому Google рекомендует использовать noindex, если цель — не допустить появления доступной страницы в Google Search. (developers.google.com)
Но есть важный нюанс: Google должен иметь возможность просканировать страницу, чтобы увидеть директиву noindex.
Поэтому такая комбинация может оказаться контрпродуктивной:
Disallow: /private-page/
вместе с:
<meta name="robots" content="noindex">
Если crawling заблокирован, Googlebot может никогда не получить HTML, содержащий инструкцию noindex. (developers.google.com)
INTERNAL LINK: robots.txt Explained
JavaScript и rendering
Современные сайты могут передавать в исходном HTML только часть значимого содержимого, а остальной контент генерировать через JavaScript.
Google указывает, что в процессе обработки он может рендерить страницы и выполнять JavaScript с помощью современной версии Chrome. Rendering важен, поскольку контент или ссылки, добавленные JavaScript, могут отсутствовать в первоначальном HTML-ответе. (developers.google.com)
Однако JavaScript rendering не отменяет необходимости делать сайт технически доступным для crawling. Важные ссылки по-прежнему должны использовать стандартную разметку ссылок, необходимые ресурсы должны оставаться доступными, а разработчикам следует проверять, что именно Google получает и рендерит. (developers.google.com)
INTERNAL LINK: Основы JavaScript SEO
Crawl Budget
Поисковые системы не могут непрерывно сканировать каждый URL в интернете.
Google описывает crawl budget как совокупность URL, которые его системы crawling могут и хотят просканировать, в основном на основе crawl capacity и crawl demand. (developers.google.com)
Для большинства обычных сайтов crawl budget не требует агрессивной оптимизации.
Текущие рекомендации Google в первую очередь относятся к очень крупным или быстро меняющимся сайтам, включая примерно:
- сайты с 1 миллионом и более уникальных страниц, которые меняются с умеренной частотой;
- сайты с 10 000 и более уникальных страниц, которые меняются очень быстро;
- сайты с большим количеством URL со статусом Discovered – currently not indexed.
Google прямо указывает, что эти числа являются приблизительными категориями, а не точными пороговыми значениями. (developers.google.com)
Крупные интернет-магазины, маркетплейсы, издательские сайты и проекты с faceted navigation могут создавать огромные пространства URL через фильтры, параметры сортировки, календари, session ID или дубликаты. В таких случаях эффективность crawling становится значительно важнее.
INTERNAL LINK: Crawl Budget Explained
Диагностика проблем с crawling
Если важная страница не появляется в поиске, сначала нужно определить, действительно ли проблема связана с crawling.
Проверьте URL с помощью URL Inspection tool в Google Search Console. Google указывает, что этот инструмент может показывать текущий статус indexing, тестировать live URL, запрашивать crawling и предоставлять информацию о загруженных ресурсах. (developers.google.com)
Затем проверьте:
- Discovery — есть ли на страницу внутренние ссылки или включена ли она в sitemap?
- robots.txt — не заблокирован ли Googlebot случайно?
- HTTP response — возвращает ли URL ожидаемый
200, редирект или ошибку? - Server availability — возникают ли ошибки DNS, сети, тайм-ауты,
429или5xx? - Rendering — доступен ли важный контент после обработки JavaScript?
- URL duplication — создают ли фильтры или параметры ненужные варианты URL?
- Server logs — запрашивал ли Googlebot этот URL на самом деле?
Для диагностики на уровне краулера особенно полезны access logs сервера, поскольку они показывают, какие запросы действительно выполнялись, а не то, что, как вы предполагаете, делал краулер.
Распространённые заблуждения
«Sitemap гарантирует crawling». Нет. Google называет sitemap подсказкой. (developers.google.com)
«Если страница просканирована, значит она проиндексирована». Нет. Просканированный контент всё ещё должен пройти дальнейшую обработку и решение об indexing. (developers.google.com)
«robots.txt удаляет страницы из Google». Не обязательно. В первую очередь он управляет crawling. (developers.google.com)
«Чем больше crawling, тем лучше SEO». Не обязательно. Цель — эффективный доступ к полезным и важным URL, а не максимальное количество запросов краулеров.
Рекомендация SeoNest
Для большинства сайтов crawling следует рассматривать как задачу доступа и архитектуры, а не как процесс, которым нужно манипулировать.
Сделайте важные страницы доступными через стандартные внутренние ссылки, поддерживайте актуальный sitemap, возвращайте корректные HTTP-ответы, не блокируйте нужные страницы или ресурсы по ошибке и контролируйте ненужные варианты URL.
Затем проверяйте результат через Search Console и серверные логи.
Серьёзно инвестировать в оптимизацию crawl budget имеет смысл только тогда, когда масштаб сайта или механизм генерации URL действительно создаёт такую необходимость.
FAQ
Может ли страница ранжироваться без crawling?
Поисковым системам обычно нужно получить содержимое страницы, прежде чем они смогут полноценно обработать и проиндексировать его. Заблокированный URL иногда может отображаться как результат только с URL на основе внешней информации, но его содержимое нельзя нормально обработать, если краулер не может получить страницу. (developers.google.com)
Как часто Google сканирует сайт?
Универсального расписания не существует. Googlebot алгоритмически определяет, что сканировать, как часто и сколько URL запрашивать, одновременно стараясь не перегружать серверы. (developers.google.com)
Ускоряет ли отправка sitemap crawling Google?
Sitemap может улучшить обнаружение страниц, особенно для новых, обновлённых, крупных или трудно обнаруживаемых наборов URL, но его отправка не гарантирует немедленный crawling. (developers.google.com)
Должна ли каждая страница быть доступна для crawling?
Нет. Административные URL, дублирующиеся комбинации URL, внутренние результаты поиска и другие пространства URL с низкой ценностью могут быть обоснованно ограничены в зависимости от архитектуры сайта. Однако страницы, предназначенные для показа в органическом поиске, как правило, должны оставаться доступными поисковым краулерам.
Является ли crawling фактором ранжирования?
Crawling в первую очередь является необходимым условием для того, чтобы поисковые системы могли получить и обработать контент. Его не следует путать с документированным сигналом ранжирования. Частое сканирование страницы само по себе не означает, что она будет ранжироваться выше.
Итог
Crawling — это уровень получения данных в поисковой системе.
Поисковые краулеры обнаруживают URL, запрашивают их у серверов, обрабатывают ответы и находят дополнительные URL для дальнейшего обхода. Хорошее техническое SEO делает этот процесс предсказуемым: важный контент легко обнаружить и получить, ненужные пространства URL не расходуют ресурсы без причины, а директивы вроде robots.txt и noindex используются по назначению.
Если crawling не работает, остальные этапы поисковой системы могут так и не получить нужный контент.
Sources
- Google Search Central — In-Depth Guide to How Google Search Works. Google for Developers. How Google Search Works (developers.google.com)
- Google Search Central — Googlebot. Google for Developers. Googlebot documentation (developers.google.com)
- Google Crawling Infrastructure — Optimize Your Crawl Budget. Google for Developers. Crawl budget documentation (developers.google.com)
- Google Search Central — Introduction to robots.txt. Google for Developers. robots.txt introduction (developers.google.com)
- Koster, M.; Illyes, G.; Zeller, H.; Sassman, L. — RFC 9309: Robots Exclusion Protocol. IETF, September 2022. RFC 9309 (rfc-editor.org)
- Google Search Central — Build and Submit a Sitemap. Google for Developers. Google sitemap documentation (developers.google.com)
- Google Search Central — Link Best Practices for Google. Google for Developers. Crawlable links documentation (developers.google.com)
- Google Crawling Infrastructure — How HTTP Status Codes Affect Google's Crawlers. Google for Developers. HTTP status code documentation (developers.google.com)
- Google Search Central — Block Search Indexing with noindex. Google for Developers. noindex documentation (developers.google.com)
- Sitemaps.org — Sitemaps XML Format. Sitemaps protocol (sitemaps.org)