Раздувание индекса: как малополезные URL расходуют ресурсы поисковых систем
Сайт может содержать тысячи URL, но далеко не каждый из них способен принести пользу пользователям поисковых систем. Фильтры товаров, параметры сортировки, дублирующиеся страницы и автоматически создаваемые архивы нередко порождают огромное количество адресов, которые практически не дают дополнительной ценности.
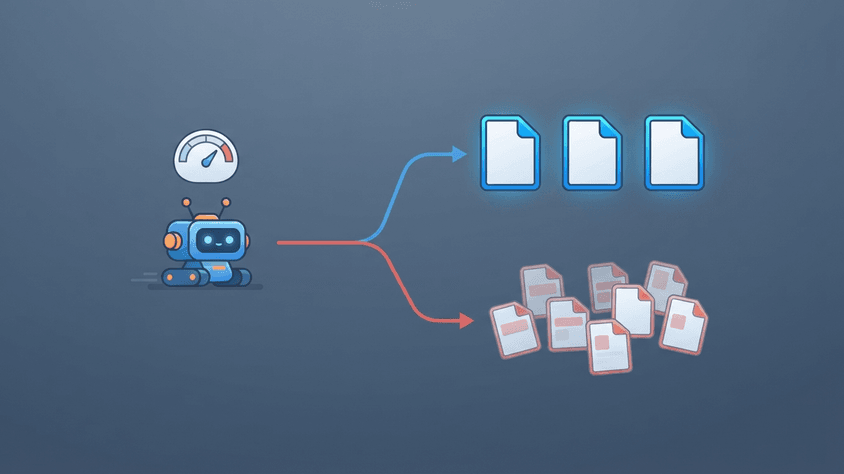
Это приводит к двум взаимосвязанным проблемам: поисковые системы могут тратить ресурсы на сканирование ненужных URL, а среди страниц сайта, доступных для индексации или уже включённых в индекс, может оказаться слишком много повторяющегося или малополезного контента.
Решение не сводится к удалению всех страниц с низкой посещаемостью или блокировке их сканирования. Важно определить, какие URL действительно заслуживают присутствия в поисковой выдаче, какие должны оставаться доступными только посетителям сайта, а какие больше не нужны.
Что такое Index Bloat?
Index bloat (раздувание индекса) — это SEO-термин, обозначающий ситуацию, когда чрезмерное количество малополезных, дублирующихся или ненужных URL допускается к индексации либо уже находится в индексе поисковой системы.
Это описательное понятие из области SEO, а не официальная метрика Google Search Console.
С ним связана другая проблема — crawl waste, или неэффективное расходование ресурсов сканирования, когда поисковые роботы многократно запрашивают URL, практически не содержащие полезной информации.
Эти проблемы пересекаются, но не являются одним и тем же. URL может расходовать ресурсы сканирования, так и не попав в индекс. И наоборот, крупный сайт может иметь миллионы проиндексированных URL без раздувания индекса, если каждая страница выполняет отдельную полезную задачу.
Главное — различать количество URL, которые генерирует сайт, и количество страниц, действительно заслуживающих присутствия в поисковой выдаче.
Почему раздувание индекса важно
Поисковые системы не могут сканировать все URL в интернете без каких-либо ограничений.
Google объясняет, что доступные ресурсы сканирования зависят от двух основных факторов: crawl capacity — возможности сайта выдерживать определённую нагрузку от сканирования, и crawl demand — того, насколько активно системы Google заинтересованы в сканировании сайта.
Когда сайт предоставляет поисковым роботам большое количество ненужных URL, могут возникнуть следующие проблемы:
- Неэффективное расходование ресурсов сканирования. Googlebot может многократно запрашивать дублирующиеся или малополезные страницы.
- Замедленное обнаружение контента. На некоторых сайтах сканирование ненужных URL способно задерживать обнаружение новых важных страниц.
- Сложности с каноникализацией. Несколько URL с похожим содержимым затрудняют поддержание согласованных сигналов о предпочтительных версиях страниц.
- Снижение качества набора проиндексированных страниц. Малополезные страницы могут присутствовать в индексе, не отвечая на значимые поисковые запросы.
- Дополнительные расходы на сервер. Сканирование большого количества динамических страниц может потреблять пропускную способность, вычислительные ресурсы и ресурсы базы данных.
Google прямо описывает проблемы сканирования, возникающие из-за чрезмерного количества URL фасетной навигации. Однако это не означает, что любой сайт с ненужными URL обязательно столкнётся с измеримым снижением позиций.
Оптимизация краулингового бюджета особенно актуальна для крупных или часто обновляемых сайтов.
Согласно рекомендациям Google за июль 2026 года, расширенное управление краулинговым бюджетом в первую очередь рассчитано на сайты с примерно миллионом или более часто обновляемых URL, сайты, где ежедневно изменяется не менее 10 000 URL, а также ресурсы, испытывающие существенные задержки в обнаружении страниц. Это приблизительные категории, а не жёсткие пороговые значения.
Для небольших сайтов обычно достаточно поддерживать корректную карту сайта и отслеживать состояние важных страниц.
Откуда появляются малополезные URL
Фасетная навигация
Фасетная навигация позволяет посетителям фильтровать товары или контент по характеристикам: цвету, размеру, цене или наличию.
Рассмотрим интернет-магазин со следующими URL:
/shoes/shoes?color=black/shoes?color=black&size=42/shoes?color=black&size=42&sort=price
Каждая комбинация может создавать отдельный URL, доступный для сканирования, даже если представленные товары во многом совпадают.
Например, категория с 12 цветами, 8 размерами и 5 вариантами сортировки теоретически может создавать 480 комбинаций — ещё до учёта остальных фильтров.
Проблема заключается не в самой фильтрации: покупателям она необходима. Сложности начинаются тогда, когда каждая комбинация превращается в отдельный URL, который поисковым роботам предлагается сканировать без соответствующей пользы для поиска.
INTERNAL LINK: Faceted Navigation SEO: Managing Filter URLs
Дублирующиеся и почти одинаковые страницы
Дубли URL могут появляться из-за параметров отслеживания, альтернативных структур адресов, версий HTTP и HTTPS или повторяющихся путей к одному контенту.
Например:
/services/web-development
/services/web-development?utm_source=newsletter
Оба URL могут возвращать одинаковое основное содержимое.
Система каноникализации Google пытается определить основной URL среди одинаковых или существенно похожих страниц. Последовательное использование канонических сигналов помогает этому процессу.
Автоматически создаваемые страницы
Системы управления контентом и самостоятельно разработанные приложения могут создавать архивы тегов, пустые страницы поиска, устаревшие списки материалов или комбинации категорий, почти не содержащие полезной информации.
При этом не каждая автоматически созданная страница является малополезной. Хорошо организованный архив категории может помогать посетителям находить контент и отвечать на реальные поисковые запросы.
Проблема возникает, когда индексируемые URL создаются без оценки того, выполняют ли они самостоятельную полезную задачу.
Как обнаружить раздувание индекса
Начните со сравнения URL, которые генерирует ваш сайт, со страницами, которые вы действительно хотите видеть в индексе поисковых систем.
1. Проверьте Search Console
Откройте Google Search Console и изучите отчёт Page indexing («Индексирование страниц»).
Обратите внимание на следующие статусы:
| Статус | Что он может означать |
|---|---|
| Crawled – currently not indexed | Google просканировал URL, но не добавил его в индекс |
| Discovered – currently not indexed | Google знает об URL, но ещё не просканировал его |
| Duplicate, Google chose different canonical | Google выбрал другой URL в качестве канонического |
| Soft 404 | Несмотря на HTTP-ответ, страница может восприниматься как отсутствующая или фактически пустая |
| Indexed | URL включён в индекс Google; следует проверить, соответствует ли это назначению страницы |
Эти статусы помогают при диагностике, но сами по себе не доказывают наличие раздувания индекса.
Исключение дублирующейся страницы может означать, что механизм каноникализации Google работает правильно. А недавно опубликованной странице, которая пока не проиндексирована, возможно, просто требуется больше времени.
2. Изучите активность сканирования
Для крупных сайтов отчёт Search Console Settings → Crawl stats («Настройки → Статистика сканирования») предоставляет сведения о запросах поисковых роботов, кодах ответов, объёмах загруженных данных и времени ответа сервера.
Логи доступа к серверу позволяют получить более подробную информацию на уровне отдельных URL. Полезный технический подход — сгруппировать подтверждённые запросы Googlebot по шаблонам URL и сравнить активность сканирования важных страниц, фильтров, редиректов и адресов, возвращающих ошибки.
3. Найдите повторяющиеся шаблоны URL
Вместо того чтобы проверять тысячи страниц по отдельности, сгруппируйте похожие адреса.
Например, если большая часть ненужных запросов приходится на URL с параметром ?sort=, причина может заключаться в одной многократно используемой функции приложения, а не в тысячах независимых SEO-проблем.
Это позволяет устранить проблему эффективнее: исправить поведение механизма генерации URL или управления сканированием, который создаёт соответствующий шаблон.
Как устранить раздувание индекса
Разные проблемы с URL требуют разных технических решений.
| Ситуация | Подходящее решение |
|---|---|
| Дублирующиеся страницы, которые необходимо объединить | rel="canonical" или постоянный редирект |
| Ненужные комбинации фильтров | Ограничить сканирование там, где это уместно |
| Страницы, которые должны оставаться доступными, но не индексироваться | noindex |
| Окончательно удалённые страницы без замены | HTTP 404 или 410 |
| Страницы, перенесённые на равноценные новые адреса | Постоянный редирект |
| Полезные страницы, ошибочно исключённые из индекса | Устранить конкретную проблему индексации или техническую ошибку |
Настройте каноникализацию дублей
Для действительно одинаковых или существенно похожих страниц используйте каноническую ссылку в HTML-элементе <head>:
<link rel="canonical" href="https://example.com/shoes">
Она указывает предпочтительный URL.
Google рассматривает канонические аннотации как сильные сигналы, но не как обязательные команды. Указанный URL должен быть подходящей основной версией соответствующего контента.
Не следует автоматически указывать родительскую категорию в качестве канонической для каждой страницы с фильтрами. Некоторые отфильтрованные страницы могут содержать уникальную информацию и отвечать на реальные поисковые запросы.
INTERNAL LINK: Canonical Tags: How Search Engines Handle Duplicate URLs
Ограничьте ненужное сканирование
Для URL фильтров, которые не должны сканироваться, Google рекомендует такие подходы, как ограничения через robots.txt или использование подходящих механизмов фильтрации на основе URL-фрагментов.
Однако запрет на сканирование не гарантирует, что уже обнаруженный URL исчезнет из поисковой выдачи.
Это различие важно: если robots.txt запрещает доступ к странице, Google не сможет прочитать расположенную на ней директиву noindex.
Если URL необходимо удалить из индекса, предоставьте Google возможность открыть страницу и обработать соответствующую директиву noindex. Для долгосрочного предотвращения сканирования определённых шаблонов URL используйте тщательно проверенные ограничения доступа поисковых роботов.
Удалите действительно устаревшие страницы
Страница, которая больше не существует и не имеет подходящей замены, обычно должна возвращать HTTP-статус 404 или 410.
Если контент переместился, вместо этого настройте перенаправление на соответствующую новую страницу.
Не стоит автоматически перенаправлять все удалённые URL на главную страницу. Такие редиректы могут вводить посетителей в заблуждение и расцениваться как soft 404.
Улучшите качество Sitemap
В XML Sitemap следует прежде всего указывать предпочтительные канонические URL, которые вы хотите сделать доступными для поиска.
Не включайте автоматически дублирующиеся адреса, устаревшие страницы или URL, намеренно исключённые из индексации.
Карта сайта помогает поисковым системам обнаруживать предпочтительные URL, но само присутствие адреса в Sitemap не гарантирует индексацию.
Как проверить результат исправлений
После внесения изменений проверьте, что затронутые шаблоны URL ведут себя ожидаемым образом.
Убедитесь, что канонические ссылки указывают на правильные адреса, директивы noindex доступны поисковым роботам, удалённые страницы возвращают соответствующие HTTP-статусы, а важные страницы по-прежнему доступны через внутренние ссылки.
Затем отслеживайте изменения в Search Console и, при наличии доступа, в серверных логах. Сравнивайте активность сканирования, решения об индексации и скорость обнаружения важных новых страниц с течением времени.
Изменения в процессах сканирования и индексации Google происходят не мгновенно. При этом сокращение числа запросов к ненужным URL не гарантирует, что освободившиеся ресурсы будут направлены на другие страницы.
Цель — улучшить состояние набора URL сайта, а не просто сократить количество страниц в индексе.
Распространённые заблуждения
Любой непроиндексированный URL указывает на проблему?
Нет. Google намеренно исключает дубли, удалённые страницы и другие URL, которым не требуется отдельное представление в поисковой выдаче. Главное — убедиться, что полезные канонические страницы индексируются.
Удаление страниц с низкой посещаемостью улучшает SEO?
Не обязательно. Страница с небольшим органическим трафиком всё ещё может быть полезна определённой аудитории, помогать внутренней навигации или содержать ценную информацию. Перед удалением оцените её назначение и качество контента.
Устранение раздувания индекса гарантирует рост позиций?
Нет. Очистка сайта от ненужных URL может повысить эффективность сканирования и уменьшить техническую сложность, но Google не гарантирует улучшения позиций только за счёт сокращения количества адресов.
Рекомендации SeoNest
Рассматривайте раздувание индекса прежде всего как проблему управления набором URL и их ценностью для поиска, а не просто как вопрос количества проиндексированных страниц.
Сосредоточьтесь на трёх действиях: сохраняйте полезные страницы, объединяйте избыточные и предотвращайте ненужную генерацию или сканирование URL.
Для небольших сайтов особое значение имеют понятная информационная архитектура, согласованные канонические сигналы и корректные карты сайта. Для крупных платформ стоит сочетать диагностику через Search Console с анализом серверных логов и шаблонов URL.
Задача не в том, чтобы любой ценой сократить количество страниц, обнаруживаемых Google. Важно сделать действительно ценный контент более доступным для обнаружения, обработки и понимания поисковыми системами.
Источники
- Google Crawling Infrastructure. Optimize Your Crawl Budget. Обновлено 22 июля 2026 года.
https://developers.google.com/crawling/docs/crawl-budget - Google Crawling Infrastructure. Managing Crawling of Faceted Navigation URLs. Обновлено 18 декабря 2025 года.
https://developers.google.com/crawling/docs/faceted-navigation - Google Search Central. How to Specify a Canonical URL with rel="canonical" and Other Methods. Обновлено 10 июля 2026 года.
https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls - Google Search Console Help. Page Indexing Report.
https://support.google.com/webmasters/answer/7440203 - Google Search Console Help. Crawl Stats Report.
https://support.google.com/webmasters/answer/9679690 - Google Search Central. Block Search Indexing with noindex. Обновлено 10 декабря 2025 года.
https://developers.google.com/search/docs/crawling-indexing/block-indexing - Google Search Central. Build and Submit a Sitemap. Обновлено 8 июля 2026 года.
https://developers.google.com/search/docs/crawling-indexing/sitemaps/build-sitemap