Frontend Observability: ошибки, Web Vitals, сеть и сессии
Страница может возвращать 200 OK, а реальный пользователь при этом увидит неработающую кнопку оформления заказа, загрузку контента в течение четырёх секунд, неудачный API-запрос или интерфейс, который смещается прямо перед кликом. Одного серверного мониторинга недостаточно, чтобы увидеть всё это, потому что значительная часть современного приложения выполняется непосредственно в браузере.
Frontend observability закрывает этот пробел. Она собирает данные из реальных браузерных сессий и помогает инженерам отвечать не только на вопрос «Сайт работает?», но и на более важный: «Что именно увидел пользователь и почему?»
Наиболее полезные системы frontend observability объединяют четыре типа данных: JavaScript-ошибки, Web Vitals, сетевую активность и контекст пользовательской сессии.
Краткий ответ
Frontend observability — это практика инструментирования сайта или веб-приложения, позволяющая понимать его реальное поведение в браузерах пользователей с помощью телеметрии. В observability обычно используются такие данные, как логи, метрики и трейсы; на frontend к ним естественным образом добавляются браузерные ошибки, метрики пользовательского опыта, Resource Timing, смены маршрутов и контекст отдельных сессий. (opentelemetry.io)
Цель не в том, чтобы собирать абсолютно всё. Нужно связать достаточно данных, чтобы пройти путь симптом → затронутая сессия → техническая причина → подтверждённое исправление.
Четыре ключевых сигнала
| Сигнал | Главный вопрос | Типичные данные |
|---|---|---|
| Ошибки | Что сломалось? | Exception, stack trace, route, release |
| Web Vitals | Что работало медленно или нестабильно? | LCP, INP, CLS |
| Сеть | Какой запрос или ресурс вызвал задержку? | DNS, connection, request, response timing |
| Сессии | Что происходило вокруг проблемы? | Route, actions, errors, requests, optional replay |
Каждый из этих сигналов полезен сам по себе. Но вместе они дают гораздо больше возможностей для диагностики.
Значение INP 620 ms говорит о том, что взаимодействие было медленным. Ошибка показывает, что какая-то функция завершилась неудачно. Запрос длительностью три секунды говорит о высокой сетевой задержке. Но если все три события относятся к одной сессии и одному взаимодействию, расследовать проблему становится значительно проще.
Видимость ошибок
Консоль браузера полезна во время разработки, но production-ошибки возникают на устройствах, которые разработчик не контролирует. Поэтому frontend-мониторинг ошибок начинается со сбора самих сбоев и полезного контекста вокруг них.
Браузеры предоставляют событие error для синхронных ошибок скриптов и событие unhandledrejection, когда Promise отклоняется без обработчика отклонения. MDN также отмечает, что ограничения cross-origin могут влиять на возможность получать некоторые события необработанного отклонения Promise. (developer.mozilla.org)
Минимальная реализация может выглядеть так:
window.addEventListener('error', (event) => {
    reportError({
        type: 'error',
        message: event.message,
        file: event.filename,
        line: event.lineno,
        column: event.colno,
        stack: event.error?.stack,
    });
});

window.addEventListener('unhandledrejection', (event) => {
    reportError({
        type: 'unhandledrejection',
        message: String(event.reason),
        stack: event.reason?.stack,
    });
});
В production сама ошибка — только начало. Полезная запись обычно включает release приложения, route, браузер, environment и идентификатор сессии. Ошибки также следует группировать, чтобы один дефект, затронувший 50 000 пользователей, не выглядел как 50 000 несвязанных инцидентов.
Минифицированные production-бандлы создают ещё одну проблему: stack trace может указывать, например, на app.8f72d.js:1:48217. Source maps связывают сгенерированный код с исходными JavaScript-, WebAssembly- или CSS-файлами. Их формат стандартизирован в ECMA-426, первая редакция которого была опубликована в декабре 2024 года. (ecma-international.org)
INTERNAL LINK: JavaScript Source Maps Explained
Web Vitals реальных пользователей
Ошибки показывают, когда программа ломается. Performance-телеметрия показывает ситуации, когда программа технически работает, но пользовательский опыт остаётся плохим.
Текущие Core Web Vitals:
- Largest Contentful Paint (LCP): скорость загрузки.
- Interaction to Next Paint (INP): отзывчивость.
- Cumulative Layout Shift (CLS): визуальная стабильность.
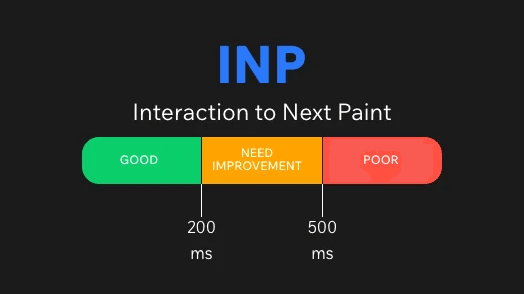
Документированные Google пороговые значения категории “good”: LCP ≤ 2.5 секунды, INP ≤ 200 миллисекунд и CLS ≤ 0.1. Оценивать их следует по 75-му перцентилю посещений страниц, отдельно учитывая мобильные и десктопные устройства. (web.dev)
Этот перцентиль имеет значение. Среднее значение может создавать впечатление, что сайт работает хорошо, хотя заметная часть пользователей регулярно сталкивается с плохим опытом.
Для production-мониторинга библиотека Google web-vitals предоставляет более удобный способ собирать измерения в соответствии с методологией Web Vitals. Google также предоставляет attribution-версию библиотеки, которая добавляет диагностический контекст для анализа плохих показателей. (web.dev)
import { onCLS, onINP, onLCP } from 'web-vitals/attribution';

function report(metric) {
    navigator.sendBeacon('/rum', JSON.stringify(metric));
}

onLCP(report);
onINP(report);
onCLS(report);
Здесь важно различать field data и lab data. Lighthouse и локальное профилирование помогают воспроизводить и исследовать проблемы в контролируемых условиях. Real User Monitoring, или RUM, показывает, что действительно происходило на реальных устройствах, в реальных сетях и пользовательских сессиях. Google прямо рекомендует использовать field-измерения при оценке Web Vitals реальных пользователей. (web.dev)
INTERNAL LINK: Core Web Vitals Explained
Сетевая observability
Медленный frontend не всегда означает проблему в JavaScript. Браузер может ждать DNS-разрешения, установки соединения, обработки запроса сервером, загрузки изображения, стороннего скрипта или ответа API.
Resource Timing API предоставляет подробную информацию о загрузке ресурсов. Текущий draft W3C Resource Timing определяет PerformanceResourceTiming, включая временные метки и метаданные, связанные с получением ресурсов страницы. (w3.org)
Браузеры предоставляют доступ к этим записям через Performance Timeline и PerformanceObserver. (w3.org)
const observer = new PerformanceObserver((list) => {
    for (const entry of list.getEntries()) {
        reportNetwork({
            url: entry.name,
            type: entry.initiatorType,
            duration: entry.duration,
            requestStart: entry.requestStart,
            responseStart: entry.responseStart,
            responseEnd: entry.responseEnd,
            transferSize: entry.transferSize,
        });
    }
});

observer.observe({
    type: 'resource',
    buffered: true,
});
PerformanceResourceTiming может показывать такие этапы, как DNS lookup, установка соединения, начало запроса, начало ответа и завершение ответа. Это позволяет различать разные классы задержек. (developer.mozilla.org)
Есть важное ограничение: подробные timing-данные для cross-origin ресурсов по умолчанию недоступны. Сторонний ресурс должен явно разрешить раскрытие timing-информации через HTTP-заголовок Timing-Allow-Origin. (w3.org)
Это помогает избежать распространённой ошибки при диагностике. Если analytics.example.com/script.js загружался две секунды, это ещё не означает, что можно сразу определить причину этих двух секунд: DNS, установка соединения, время ответа сервера или скачивание тела ответа. Доступный объём данных зависит от правил безопасности браузера и конфигурации сервера.
Контекст сессии
Четвёртый сигнал отвечает на другой вопрос: что происходило в момент возникновения проблемы?
Представим ошибку Cannot read properties of undefined. Без дополнительного контекста инженеру может потребоваться вручную воспроизвести её.
Теперь добавим:
Release: 2026.09.25-4
Route: /checkout/payment
Session: a8f2...
Previous action: Click "Pay"
API: POST /payments → 500
INP: 684 ms
Error: PaymentForm.submit
Теперь инцидент уже рассказывает целую историю.
Контекст сессии не обязательно означает запись каждого действия пользователя. Начать можно с лёгких метаданных: session ID, route, последовательность навигации, release, релевантные действия, ошибки, performance-метрики и корреляция запросов.
Session replay может дать дополнительный визуальный контекст, но он также создаёт серьёзные требования к приватности. Его реализация зависит от конкретного поставщика и не является стандартом browser observability. Например, Datadog документирует механизмы masking для Session Replay и указывает, что можно настроить систему так, чтобы замаскированные значения не покидали устройство пользователя. (docs.datadoghq.com)
Практическое правило простое: собирайте только тот минимум информации, который необходим для диагностики проблемы. Маскируйте значения полей форм и чувствительный DOM-контент, полностью исключайте пароли и authentication tokens, используйте sampling и осознанно определяйте сроки хранения данных.
Связывайте сигналы
Наибольший эффект во frontend observability обычно даёт не сбор ещё одной метрики, а корреляция уже имеющихся данных.
Предположим, пользователи сообщают, что страницы товаров иногда словно «зависают».
Полезный процесс диагностики может выглядеть так:
Симптом: “Add to Cart” реагирует медленно. Измерение: определены сессии с плохим INP. Возможная причина: длительная задача на клиентской стороне или тяжёлая логика приложения. Подтверждение: INP attribution показывает проблемное взаимодействие; в тех же сессиях виден конкретный путь выполнения JavaScript. Исправление: уменьшить объём блокирующей работы или разбить её на части. Повторное измерение: сравнить распределение INP после нового release.
Другой инцидент может начинаться с высокого LCP, затем привести к медленной загрузке изображения в Resource Timing и в итоге — к проблеме конфигурации origin-сервера или CDN.
Observability работает тогда, когда инженер может переходить между этими сигналами, не восстанавливая вручную всю картину из несвязанных dashboard'ов.
Типичные ошибки
Отслеживать только средние значения. Распределение performance-метрик имеет значение. Медиана может скрывать плохой пользовательский опыт, который регулярно затрагивает заметную часть аудитории.
Собирать ошибки без информации о release. Нужно понимать, какой deployment привёл к проблеме или исправил её.
Измерять Web Vitals без attribution. Знать, что INP равен 600 ms, менее полезно, чем знать, какое именно взаимодействие привело к этому значению.
Бесконечно логировать каждый сетевой запрос. Большой объём телеметрии увеличивает расходы на хранение, стоимость системы и риски для приватности. Используйте разумный sampling и сохраняйте диагностически полезные поля вместо полного содержимого всех запросов.
Считать session replay полноценной observability-системой. Просмотр проблемной сессии может показать, что произошло, но именно ошибки, timings и корреляция запросов помогают понять почему.
Считать браузерную телеметрию неограниченной. Cross-origin policies, поддержка браузеров и ограничения API влияют на то, какие данные можно получить.
Рекомендация SeoNest
Стройте frontend observability постепенно.
Начните с production error reporting и release tracking. Затем добавьте реальные пользовательские показатели LCP, INP и CLS. После этого собирайте network timing для запросов и ресурсов, которые действительно важны для приложения. Наконец, объедините эти сигналы через privacy-safe идентификатор сессии и добавляйте sampled session replay только там, где он действительно даёт дополнительную диагностическую ценность.
Целевая архитектура должна позволять инженеру начать с бизнес-симптома — например, «увеличилось число ошибок при оформлении заказа» или «мобильные страницы товаров стали медленнее» — и перейти к техническим доказательствам без догадок.
OpenTelemetry может помочь стандартизировать traces, metrics и logs между системами, однако browser instrumentation следует оценивать отдельно: в документации OpenTelemetry JavaScript клиентская browser instrumentation в настоящее время описывается как экспериментальная и в значительной степени не специфицированная. (opentelemetry.io)
FAQ
Frontend observability и мониторинг — это одно и то же?
Не совсем. Мониторинг обычно отвечает на заранее определённые вопросы, например превысил ли error rate или LCP установленный порог. Observability шире: собранная телеметрия должна помогать расследовать и те сбои, которые заранее не удалось предусмотреть.
Нужно ли записывать каждую сессию?
Обычно нет. Ошибки и лёгкие RUM-сигналы часто можно собирать значительно шире, тогда как session replay имеет смысл семплировать из-за требований к хранению, стоимости и приватности.
Достаточно ли Core Web Vitals?
Нет. Они описывают важные стороны пользовательского опыта, но не объясняют каждый сбой. Web Vitals становятся значительно полезнее, когда связаны с ошибками, ресурсами, действиями приложения и информацией о release.
Стоит ли создавать собственную observability-платформу?
Обычно лучше начать со стандартных browser API и проверенного telemetry backend. Собственную систему сбора имеет смысл создавать только тогда, когда ваши требования оправдывают дополнительные инженерные и операционные затраты.
Итог
Frontend observability — это не просто dashboard с браузерными метриками. Это связанная система технических доказательств.
Ошибки показывают, что сломалось. Web Vitals показывают, что почувствовали пользователи. Сетевая телеметрия помогает понять, где было потрачено время. Контекст сессии показывает, что происходило вокруг сбоя.
Когда эти сигналы связаны достаточным контекстом, production-debugging превращается из попыток воспроизвести расплывчатые жалобы пользователей в расследование на основе конкретных данных из того самого браузера, где проблема действительно произошла.
Источники
- OpenTelemetry — What is OpenTelemetry? Current documentation. OpenTelemetry documentation
- OpenTelemetry — Observability Primer. Current documentation. Observability Primer
- Google / web.dev — Web Vitals. Web Vitals
- Google / web.dev — Getting Started with Measuring Web Vitals. Web Vitals measurement guide
- GoogleChrome — web-vitals library documentation. web-vitals repository and documentation
- W3C Web Performance Working Group — Resource Timing, Candidate Recommendation Draft, September 1, 2026. W3C Resource Timing specification
- MDN Web Docs — Window: error event, updated August 21, 2026. MDN error event documentation
- MDN Web Docs — PerformanceResourceTiming. MDN PerformanceResourceTiming documentation
- Ecma International — ECMA-426: Source map format specification, 1st edition, December 2024. ECMA-426
- Datadog — Reducing Data Related Risks / RUM & Session Replay. Datadog data security documentation