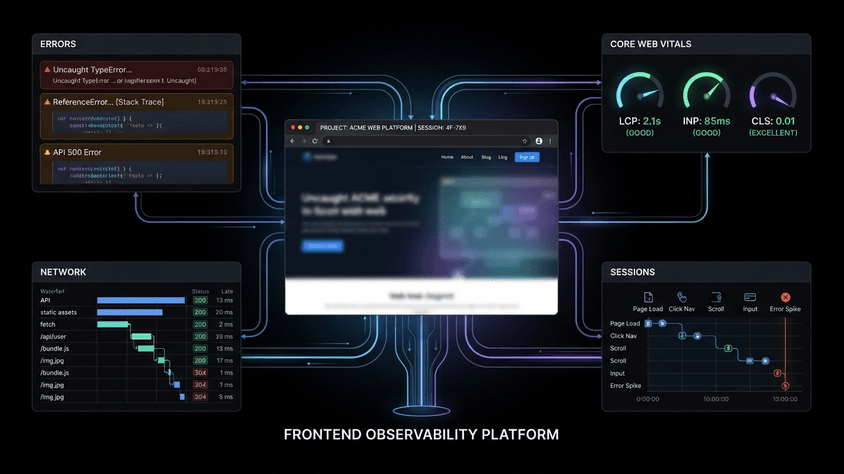
Backend observability: so‘rovlar, querylar, navbatlar va bog‘liqliklar
Backend 200 OK qaytarayotgan bo‘lsa ham, tizim baribir nosog‘lom holatda bo‘lishi mumkin. So‘rovlar sekinlashayotgan, database chaqiruvlari ko‘payayotgan, vazifalar navbatda kutib qolayotgan yoki tashqi API javob vaqtining katta qismini egallayotgan bo‘lishi mumkin. Faqat CPU va xotira grafiklari bunday muammolarning sababini tushuntirish uchun ko‘pincha yetarli emas.
Backend observability — bu backend nima qilayotganini, vaqt qayerga sarflanayotganini, nima ishlamayotganini va nima sababdan tushunish uchun yetarli signallarni yig‘ishdir. Ko‘pchilik application backendlar uchun to‘rtta yo‘nalish yaxshi boshlang‘ich model bo‘la oladi: so‘rovlar, database querylar, navbatlar va bog‘liqliklar.
Qisqa javob
Backend observability tizimdagi ish jarayonini boshidan oxirigacha kuzatish imkonini berishi kerak:
request → application code → database → queue → worker → downstream dependency
Metrics latency yoki error rate oshishi kabi umumiy tendensiyalarni ko‘rsatadi. Traces komponentlar orasidagi operatsiyalarni bir-biriga bog‘laydi. Logs esa batafsil hodisalar va kontekstni beradi. OpenTelemetry trace va span identifikatorlari orqali bu signallarni o‘zaro bog‘lashni qo‘llab-quvvatlaydi, W3C Trace Context esa tracing ma’lumotlarini servislar orasida uzatish uchun standart mexanizmni belgilaydi. (opentelemetry.io)
Maqsad hamma narsani yig‘ish emas. Muhandis “API sekin ishlayapti” degan holatdan “bu endpoint aynan shu query, queue yoki dependency sabab kutyapti” degan aniq xulosaga kela olishi uchun yetarli dalil yig‘ish kerak.
Nimalarni kuzatish kerak?
| Yo‘nalish | Foydali signallar | Qaysi savolga javob beradi |
|---|---|---|
| So‘rovlar | rate, latency distribution, status, errors | Qaysi endpointlar sekin yoki xato bilan tugayapti? |
| Querylar | duration, query pattern, calls, errors | Kechikishga database sabab bo‘lyaptimi? |
| Navbatlar | depth, wait time, processing time, failures | Asinxron ishlar ortda qolib ketyaptimi? |
| Bog‘liqliklar | latency, errors, timeouts | Muammo boshqa servisdan kelayaptimi? |
Bu model umumiy service monitoring’ni to‘ldiradi. Google SRE qo‘llanmasida latency, traffic, errors va saturation foydalanuvchiga xizmat ko‘rsatuvchi tizimlar uchun to‘rtta asosiy monitoring signali sifatida ko‘rsatiladi. (sre.google)
So‘rovlardan boshlang
So‘rovlar odatda eng yaxshi boshlang‘ich nuqta hisoblanadi, chunki ular foydalanuvchi yoki boshqa tizim backenddan real ravishda qanday ish bajarishni so‘raganini ko‘rsatadi.
HTTP API uchun quyidagi o‘lchovlar foydali:
- soniyasiga so‘rovlar soni;
- response status yoki application natijasi;
- request duration;
- p50, p95 yoki p99 kabi latency distribution;
- route yoki operation;
- service va deployment version.
Faqat o‘rtacha response time’ga tayanmang. Servisning o‘rtacha ko‘rsatkichi normal bo‘lib ko‘rinishi mumkin, ammo so‘rovlarning kichik bir qismi juda sekin ishlayotgan bo‘lishi mumkin. Google SRE tail latency muammosiga alohida e’tibor qaratadi, histogram turidagi o‘lchovlar esa bunday taqsimotni ko‘rish imkonini beradi. Prometheus ham histogramlarni request duration kabi taqsimotlarni ifodalash mexanizmi sifatida hujjatlashtiradi. (sre.google)
OpenTelemetry HTTP client va server spanlari uchun standart semantic conventions belgilaydi. Bir xil atributlar va operation nomlaridan foydalanish turli framework va servislar orasidagi tracelarni solishtirishni osonlashtiradi. (opentelemetry.io)
INTERNAL LINK: HTTP so‘rovlar unumdorligini monitoring qilish
Querylarni kuzating
Tasavvur qiling, /api/products sekin ishlay boshladi.
Request muammo borligini ko‘rsatadi, ammo nima sabab bo‘lganini har doim ham tushuntirib bermaydi. Trace quyidagicha ko‘rinishi mumkin:
GET /api/products             680 ms
├── authentication             12 ms
├── SELECT products           610 ms
└── response serialization     18 ms
Endi tekshiruv yo‘nalishi o‘zgaradi. Controller’ni optimallashtirish o‘rniga database operatsiyasini tekshirish kerak.
OpenTelemetry chaqiruvchi application tomonidan kuzatiladigan database operatsiyalarini ifodalash uchun database client spanlarini belgilaydi. (opentelemetry.io)
Database uchun foydali signallarga query duration, chaqiruvlar soni, xatolar, connection pool bosimi va normallashtirilgan query identity kiradi. Har bir literal SQL statement’ni yozib borish har doim ham to‘g‘ri emas: query matnida maxfiy yoki yuqori cardinality’ga ega qiymatlar bo‘lishi mumkin. Shu sabab instrumentation database va observability stack’ning sanitization hamda data handling qoidalariga mos bo‘lishi kerak.
PostgreSQL’da pg_stat_statements SQL statementlar uchun planning va execution statistikalarini jamlay oladi. Bu qimmat yoki juda ko‘p bajariladigan query patternlarini aniqlashda foydali. (postgresql.org)
Shubhali query topilgach, EXPLAIN uning execution plan’ini ko‘rsatadi. EXPLAIN ANALYZE esa query’ni amalda bajaradi va plan node’lari uchun real row count hamda execution timing ma’lumotlarini beradi. Bu estimates, scans, joins yoki boshqa operatsiyalar muammoga sabab bo‘layotganini tekshirishga yordam beradi. (postgresql.org)
INTERNAL LINK: Sekin SQL querylarni diagnostika qilish
Queue vaqtini alohida o‘lchang
Queue latency tushunchasini o‘zgartiradi.
Tasvirni qayta ishlash vazifasini olaylik:
created
   ↓
waiting in queue: 14.2 s
   ↓
worker starts
   ↓
processing: 820 ms
   ↓
completed
Faqat worker execution vaqtiga qaralsa, operatsiya 820 ms davom etgandek ko‘rinadi. Ammo application nuqtai nazaridan vazifaning bajarilishi 15 soniyadan ko‘proq vaqt olgan.
Bu farq muhim.
Queue texnologiyasi bunday signallarni taqdim etsa, kamida kutilayotgan ish hajmi, kutish vaqti, processing duration hamda failure yoki retry holatlarini kuzating. Faqat queue depth’ga qarash chalg‘itishi mumkin: o‘nta yengil vazifa bilan o‘nta og‘ir vazifa bir xil workload degani emas.
Google SRE ortiqcha queue length’ni bir vaqtning o‘zida latency va resource muammosi sifatida tasvirlaydi: navbatda turgan so‘rovlar resurs ishlatadi va ish tizim qayta ishlay oladigan tezlikdan tezroq kelayotgan bo‘lsa, overload’ni yanada kuchaytirishi mumkin. (sre.google)
Asinxron tizimlarda distributed tracing ham murakkablashadi, chunki producer va consumer turli vaqtda ishlaydi. OpenTelemetry messaging conventions producer va consumer orasida propagation’ni alohida ko‘rib chiqadi, shunda messaging infrastructure orqali o‘tgan operatsiyalarni ham o‘zaro bog‘lash mumkin bo‘ladi. (opentelemetry.io)
INTERNAL LINK: Queue monitoring va worker unumdorligi
Bog‘liqliklarni o‘lchang
Ko‘pchilik production backendlar yolg‘iz ishlamaydi. Bitta request quyidagilarga bog‘liq bo‘lishi mumkin:
Application
├── PostgreSQL
├── Redis
├── payment API
├── object storage
└── internal user service
Shuning uchun dependency umumiy request duration ichida yo‘qolib ketmasdan, alohida kuzatiladigan operation sifatida ko‘rinishi kerak.
Har bir muhim dependency uchun odatda latency, request volume, error rate, timeout behavior va chaqiruvchi operation kabi signallar foydali. Bu muhandisga bir-biridan keskin farq qiluvchi ikki holatni ajratish imkonini beradi:
API slow
└── application code slow
va:
API slow
└── payment provider: 2.4 s
Bu farq tekshiruvni qayerda davom ettirish kerakligini belgilaydi.
Butun trace’ni bog‘lang
Bir xil operation’ni service boundary’lar orqali kuzatish mumkin bo‘lganda distributed observability ancha foydali bo‘ladi.
W3C Trace Context buning uchun traceparent va tracestate HTTP headerlarini belgilaydi. traceparent standartlashtirilgan trace ma’lumotini tashiydi. Shu orqali turli tracing implementation’lardan foydalanuvchi tizimlar ham operatsiyalar o‘rtasidagi bog‘lanishni saqlab qolishi mumkin. (w3.org)
Konseptual ko‘rinishi:
Browser
   │
   ▼
API Gateway
trace-id: abc
   │
   ▼
Order Service
trace-id: abc
   │
   ├── PostgreSQL
   │     trace-id: abc
   │
   └── Payment Service
         trace-id: abc
OpenTelemetry buni context propagation deb ataydi. Downstream service trace context’ni qabul qiladi va shu distributed trace’ning bir qismi sifatida o‘z span’ini yaratadi. (opentelemetry.io)
Propagation bo‘lmasa, muhandislar ajratilgan operatsiyalarni ko‘radi. Propagation bo‘lsa, ular sababiy bog‘langan yo‘lni ko‘ra oladi.
Amaliy diagnostika jarayoni
Tasavvur qiling, foydalanuvchilar checkout ba’zan besh soniya vaqt olayotganini aytishmoqda.
Avval request metric’dan boshlang. Checkout latency haqiqatan oshganini va muammo barcha requestlarga ta’sir qilayotganini yoki asosan sekin tail’da ko‘rinayotganini tekshiring.
Keyin sekin trace’ni oching:
POST /checkout               5.1 s
├── validate cart             8 ms
├── SELECT inventory         31 ms
├── payment request           4.8 s
└── create order             76 ms
Birinchi navbatda database’ni tekshirish ehtimol to‘g‘ri yo‘l emas. Trace’ning asosiy qismini payment dependency egallagan.
Xuddi shu vaqt oralig‘i uchun dependency metrics va logs’ni tekshiring. Remote latency oshishi, timeouts, retries yoki connection failures mavjudligini qidiring. O‘zgarish kiritilgach, o‘sha request va dependency signallarini yana o‘lchang.
Jarayon quyidagicha:
symptom → measurement → suspected component → confirmation → fix → re-measurement
Bu shunchaki birinchi shubhali ko‘ringan komponentni optimallashtirishdan ancha ishonchli.
Observability’dagi keng tarqalgan xatolar
Birinchi xato — application kontekstisiz infrastructure metrics yig‘ish. CPU usage saturation’ni ko‘rsatishi mumkin, ammo qaysi endpoint yoki query bunga sabab bo‘lganini aytib bermaydi.
Ikkinchi xato — hamma narsani log qilish, lekin hech narsani o‘zaro bog‘lamaslik. Millionlab log yozuvlari ularni yaratgan request yoki job bilan bog‘lab bo‘lmasa, tekshirish uchun juda noqulay. OpenTelemetry aynan shu correlation uchun log recordlarga trace va span identifikatorlarini qo‘shishni qo‘llab-quvvatlaydi. (opentelemetry.io)
Uchinchi xato — asinxron kutish vaqtini e’tiborsiz qoldirish. Worker processing time bilan job’ning end-to-end latency’si bir xil o‘lchov emas.
To‘rtinchi xato — latency’ni faqat o‘rtacha qiymat orqali baholash. Tail latency qabul qilinadigan o‘rtacha qiymat ortida yashiringan muammolarni ko‘rsatishi mumkin.
Va nihoyat, telemetry cardinality’ni nazoratsiz oshirib yubormang. User ID’lar, ixtiyoriy parametrli to‘liq URL’lar, raw SQL qiymatlari, request body’lar yoki noyob job ID’lar metric tizimlarini qimmatlashtirishi va maxfiy ma’lumotlarni ochib qo‘yishi mumkin. Yuqori cardinality’ga ega diagnostik kontekstni har bir qiymatni metric label’ga aylantirish o‘rniga, bunday ma’lumotlar uchun mo‘ljallangan tizimlarda saqlang.
SeoNest tavsiyasi
Request boundary’dan boshlang va instrumentation’ni tashqariga qarab kengaytiring.
Har bir muhim backend operation uchun avval request latency, traffic va errors’ni kuzatishni yo‘lga qo‘ying. Keyin database calls, messaging operations va muhim downstream dependencies’ni trace qilinadigan operatsiyalar sifatida ko‘rsating. HTTP calls va asynchronous messages orqali trace context’ni saqlang hamda logs’ni shu execution context bilan bog‘lang.
Darhol o‘nlab dashboard yaratishdan boshlamang. Avval kichikroq savolga javob bering:
Muhandis bitta sekin yoki muvaffaqiyatsiz request’ni olib, vaqt yoki xato qayerdan kelganini aniqlay oladimi?
Agar javob yo‘q bo‘lsa, backend observability’da hali ham muhim ma’lumotlar yetishmayapti.
FAQ
Faqat loglar yetarlimi?
Odatda yo‘q. Logs batafsil hodisalarni beradi, metrics umumiy patternlarni aniqlash uchun qulayroq, traces esa request ichidagi operatsiyalar qanday bog‘langanini ko‘rsatadi. Uchalasini o‘zaro bog‘lash ularni alohida ishlatishdan foydaliroq.
Har bir SQL query trace span bo‘lishi kerakmi?
Foydali database operatsiyalari kuzatilishi kerak, ammo instrumentation hajmi, query ichidagi maxfiy ma’lumotlar va telemetry narxini ham hisobga olish kerak. Automatic instrumentation cheksiz hajmda xavfsiz deb qabul qilinmasdan, ongli ravishda sozlanishi kerak.
Queue uchun nimalarni kuzatish kerak?
Queue yoki backlog hajmi, kutish vaqti, processing duration, failures, retries va worker capacity yaxshi boshlang‘ich signallardir. Aniq signallar messaging system va workload’ga bog‘liq.
Monitoring va observability o‘rtasidagi farq nima?
Monitoring odatda oldindan belgilangan system signals va conditions’ni kuzatadi. Observability esa metrics, traces va logs kabi telemetry orqali tizim xatti-harakatini, jumladan dashboard yoki alert yaratilgan paytda oldindan ko‘zda tutilmagan muammolarni ham tekshirish imkonini beradi.
Distributed tracing uchun OpenTelemetry shartmi?
Yo‘q. W3C Trace Context vendor-neutral standart hisoblanadi va turli tracing implementation’lar distributed context propagation’ni qo‘llab-quvvatlashi mumkin. OpenTelemetry telemetry yaratish va uzatish uchun keng qo‘llaniladigan API, SDK, semantic conventions va tooling taqdim etadi. (w3.org)
Yakuniy xulosa
Yaxshi backend observability latency’ni noaniq simptomdan o‘lchanadigan operatsiyalar ketma-ketligiga aylantiradi.
Faqat “request ikki soniya davom etdi” degan joyda to‘xtamang.
Bu ikki soniya application code bajarilishiga, SQL kutishga, queue’da turishga yoki boshqa service’ni chaqirishga sarflanganini aniqlang. Requests simptomni ko‘rsatadi; queries, queues va dependencies vaqt qayerga ketganini ko‘rsatadi; traces va ular bilan bog‘langan logs esa dalillarni birlashtiradi.
Backend nosog‘lom ekanini shunchaki bilish bilan nima uchun nosog‘lom ekanini tushuntira olish o‘rtasidagi asosiy farq mana shu.
Sources
- W3C — Trace Context. W3C Recommendation.
traceparentvatracestateuchun standartlashtirilgan propagation’ni belgilaydi. W3C Trace Context - OpenTelemetry — Semantic Conventions for HTTP Spans. OpenTelemetry’ning rasmiy spetsifikatsiyasi. OpenTelemetry HTTP Spans
- OpenTelemetry — Semantic Conventions for Database Client Spans. OpenTelemetry’ning rasmiy spetsifikatsiyasi. OpenTelemetry Database Spans
- OpenTelemetry — Semantic Conventions for Messaging Spans. OpenTelemetry’ning rasmiy spetsifikatsiyasi. OpenTelemetry Messaging Spans
- OpenTelemetry — Context Propagation and Logging Specification. Distributed context va log correlation bo‘yicha rasmiy hujjatlar. OpenTelemetry Context Propagation OpenTelemetry Logging
- Google — Site Reliability Engineering: Monitoring Distributed Systems. Rob Ewaschuk, edited by Betsy Beyer. Latency, traffic, errors, saturation va tail latency masalalarini yoritadi. Google SRE — Monitoring Distributed Systems
- Google — Site Reliability Engineering: Addressing Cascading Failures. Queueing, overload, latency va saturation holatlarini yoritadi. Google SRE — Addressing Cascading Failures
- Prometheus — Histograms and Summaries. Request latency kabi taqsimotlarni ifodalash bo‘yicha rasmiy hujjat. Prometheus Histograms and Summaries
- PostgreSQL —
pg_stat_statementsand UsingEXPLAIN. Query statistikasi va execution plan tahlili bo‘yicha PostgreSQL’ning rasmiy hujjatlari. PostgreSQL pg_stat_statements PostgreSQL Using EXPLAIN